

部署模型服务
在启动表单里选择 部署类型:模型 API,启动的实例会运行 vLLM 而不是 JupyterLab,并提供一个兼容 OpenAI 的接口。模型和参数由你决定,GPU 不与他人共享,实例运行期间每小时消耗积分。
这和 Token Factory 不是一回事:Token Factory 里的模型由平台免费托管。需要 Token Factory 没有的模型、想自己设置 vLLM 参数,或者需要不与他人共享的吞吐时,才需要自己部署模型服务。
用公共模板启动
Section titled “用公共模板启动”公共模板已经配好了经过验证的模型、规格和 vLLM 启动命令。
- 在 首页 把 部署类型 设为 模型 API。
- 在 模型 里选一个公共模板,例如 MiniCPM5-2B。表单会显示模板的 模型来源、资源池、vLLM 启动命令 和 规格,这些都不能修改。
- 点 启动实例,查看启动进度,见启动实例。
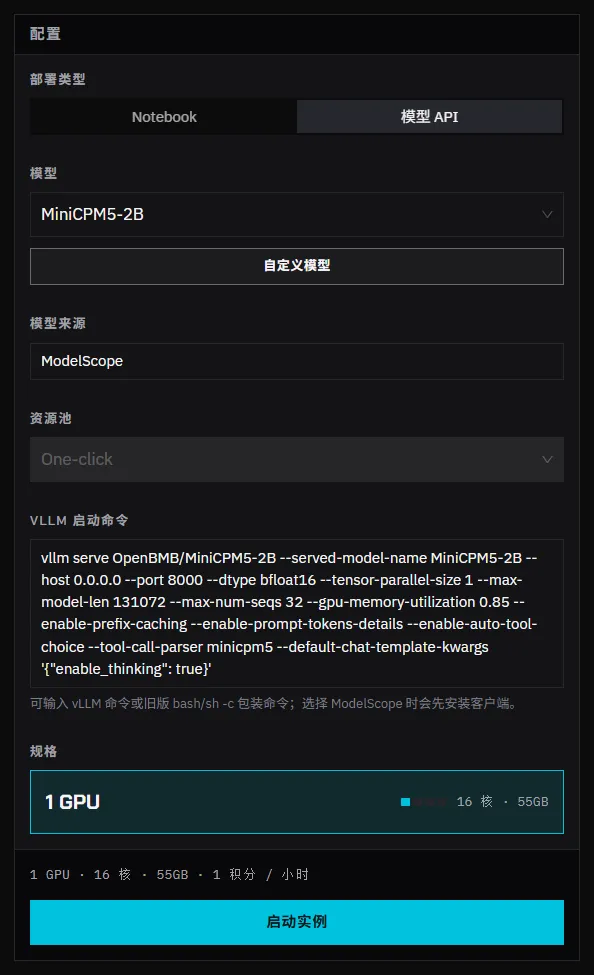
模型 下拉框里列出的是你可以使用的模板。如果一个都没有,表单会提示,此时请改用自定义模型。
部署自定义模型
Section titled “部署自定义模型”-
在 首页 把 部署类型 设为 模型 API,点 自定义模型。
-
填写表单:
字段 填什么 模型名称 客户端在 model字段里传的名字,也会出现在 API 示例里。模型来源 权重从哪里下载:Hugging Face(镜像) 或 ModelScope。选 ModelScope 时,平台会先安装它的客户端,再运行你的命令。 资源池 实例运行在哪个资源池。大多数账号只有一个。 vLLM 启动命令 启动服务的命令。 规格 选显存能装下模型权重和 KV cache 的规格。 -
点 启动实例。
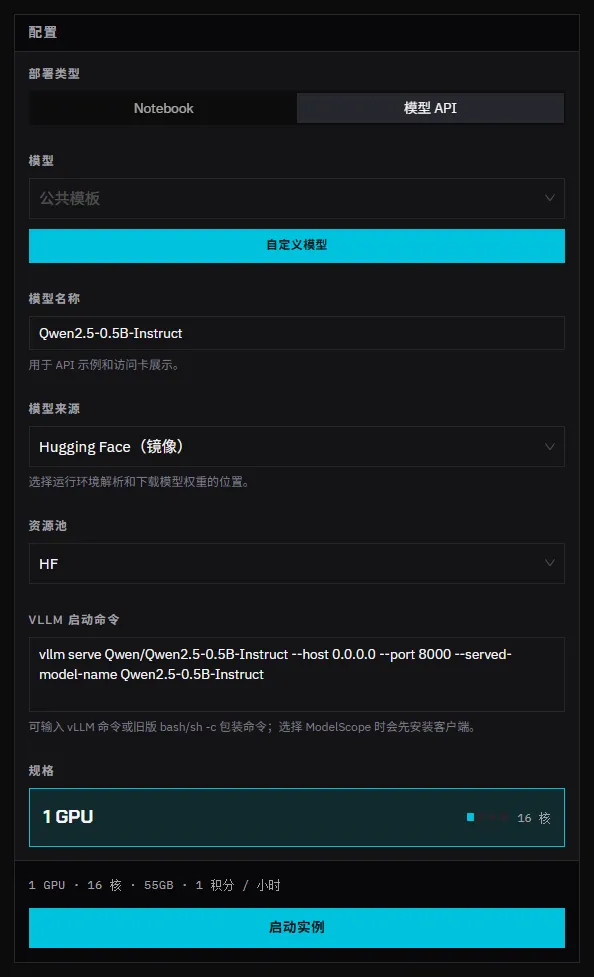
表单会按模型来源预填一个示例命令:
vllm serve Qwen/Qwen2.5-0.5B-Instruct --host 0.0.0.0 --port 8000 --served-model-name Qwen2.5-0.5B-Instruct某个模型第一次启动时要先下载权重,所以会比之后的启动慢。
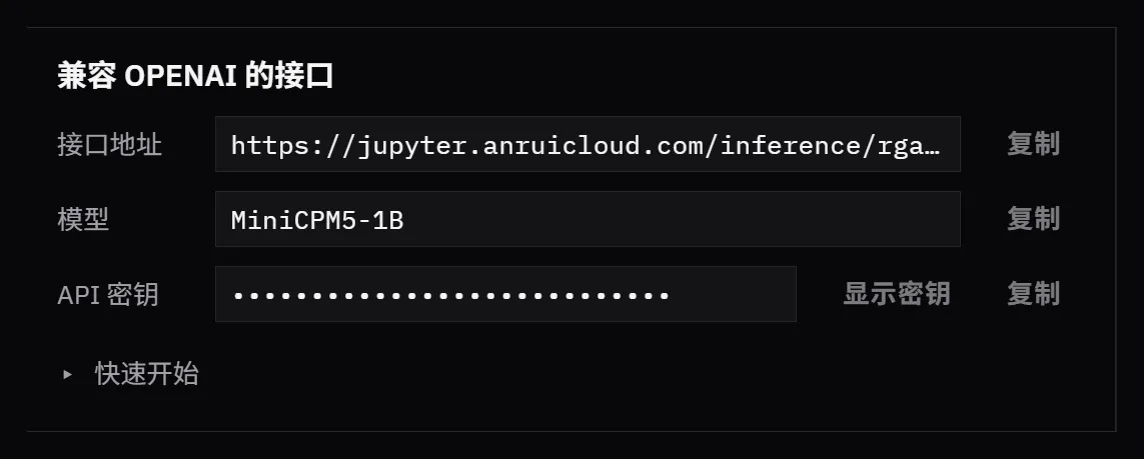
实例就绪后,兼容 OpenAI 的接口 卡片会显示:
- 接口地址:你这个实例的 base URL。
- 模型:
model字段要填的值。 - API 密钥:这个端点的 API Key,以
sk-开头,每次启动单独生成,不是你的 Token Factory API Key。 - 快速开始:一条可以直接运行的 curl 命令。
curl <base-url>/chat/completions \ -H "Authorization: Bearer <api-key>" \ -H "Content-Type: application/json" \ -d '{"model":"Qwen2.5-0.5B-Instruct","messages":[{"role":"user","content":"你好"}]}'请求直接发到 vLLM,所以 vLLM 提供什么接口,端点就有什么接口,比如 /v1/completions 和 /v1/embeddings。Token Factory 的限流和请求过滤在这里都不适用,见模型服务接口。
每次启动后,请从卡片上复制 接口地址 和 API 密钥,不要把它们写死在代码里。
端点只在实例运行期间可用。用完请销毁实例:在 首页 点 销毁实例,见销毁实例。
服务没有响应时
Section titled “服务没有响应时”- 在实例卡片上点 查看日志。vLLM 的报错会打印在这里,比如模型装不进显存。
- 确认启动命令里有
--host 0.0.0.0 --port 8000。 - 确认
model字段和 模型名称 一致。
见疑难排查。